Domain linux-news.de kaufen?
Wir ziehen mit dem Projekt
linux-news.de um.
Sind Sie am Kauf der Domain
linux-news.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain linux-news.de kaufen?
Wie funktioniert ein Data Warehouse?
Ein Data Warehouse ist eine spezialisierte Datenbank, die große Mengen an strukturierten und unstrukturierten Daten aus verschiedenen Quellen sammelt, speichert und verwaltet. Es dient dazu, Daten zu konsolidieren, zu analysieren und für Entscheidungsfindungen zugänglich zu machen. Um ein Data Warehouse zu erstellen, werden Daten aus verschiedenen operativen Systemen extrahiert, transformiert und geladen (ETL-Prozess). Die Daten werden dann in einem zentralen Repository gespeichert, wo sie für Analysen und Berichterstellung zur Verfügung stehen. Data Warehouses verwenden spezielle Datenmodellierungstechniken wie den Stern- oder Schneeflockenschema, um Daten effizient zu strukturieren und abzufragen. Business Intelligence Tools werden häufig verwendet, um Daten aus dem Data Warehouse zu extrahieren, zu analysieren und in aussagekräftige Berichte und Dashboards umzuwandeln. Durch die zentrale Speicherung und Aufbereitung von Daten ermöglicht ein Data Warehouse Unternehmen, fundierte Entscheidungen zu treffen, Trends zu identifizieren und Geschäftsprozesse zu optimieren. **
Was ist ein Data Warehouse?
Was ist ein Data Warehouse? **

Ähnliche Suchbegriffe für Groupware-enabled-Data-Warehouse
Top-Angebote
Produkte zum Begriff Groupware-enabled-Data-Warehouse:
-
Building a Scalable Data Warehouse with Data Vault 2.0, Fachbücher von Michael Olschimke, Dan LinstedtDas Data Vault wurde von Dan Linstedt im US-Verteidigungsministerium erfunden und der Standard wurde erfolgreich auf Data-Warehousing-Projekte in Organisationen unterschiedlicher Grössenordnungen angewendet, von kleinen bis hin zu grossen Unternehmen. Aufgrund seines vereinfachten Designs, das von der Natur inspiriert ist, hilft der Data Vault 2.0-Standard, typische Misserfolge im Data Warehousing zu vermeiden. "Building a Scalable Data Warehouse" behandelt alles, was man wissen muss, um ein skalierbares Data Warehouse von Anfang bis Ende zu erstellen, einschliesslich einer Präsentation der Data Vault-Modellierungstechnik, die die Grundlagen für die Erstellung einer technischen Data Warehouse-Schicht bietet. Das Buch erörtert, wie man das Data Warehouse schrittweise unter Verwendung der agilen Data Vault 2.0-Methodik aufbaut. Darüber hinaus lernen die Leser, wie sie die Eingabeschicht (die Staging-Schicht) und die Präsentationsschicht (Data Mart) der Data Vault 2.0-Architektur erstellen können.63,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Open Source ThreatsKaspersky Threat Data Feeds – Open Source Threats In einer Zeit, in der Cyberbedrohungen komplexer und zielgerichteter denn je sind, ist eine umfassende Bedrohungsüberwachung unerlässlich. **Kaspersky Threat Data Feeds - Open Source Threats** stellt eine innovative Lösung dar, die Sicherheitsverantwortlichen aktuelle und relevante Informationen zu Bedrohungen bietet, die aus Open-Source-Quellen stammen. Diese Bedrohungsfeeds ermöglichen es Unternehmen, sich kontinuierlich über die neuesten Bedrohungen aus dem Open-Source-Bereich zu informieren und ihre Sicherheitsmaßnahmen entsprechend anzupassen. Mit Kaspersky Threat Data Feeds - Open Source Threats können Unternehmen proaktiv auf Bedrohungen reagieren und so ihre Widerstandsfähigkeit gegenüber Cyberangriffen deutlich verbessern. Überblick über Kaspersky Threat Data Feeds - Open Source Threats Die Lösung **Kaspersky Threat Data Feeds - Open Source Threats** bietet Unternehmen Zugang zu einer Fülle an Bedrohungsdaten, die speziell aus Open-Source-Quellen gesammelt werden. Diese Feeds bieten detaillierte Informationen über aktuelle Bedrohungen und ermöglichen eine proaktive Abwehr. Durch die kontinuierliche Analyse und Filterung relevanter Daten aus öffentlich zugänglichen Quellen hilft Kaspersky Unternehmen dabei, potenzielle Gefahren frühzeitig zu erkennen und geeignete Schutzmaßnahmen zu implementieren. Hauptfunktionen Echtzeit-Updates zu Open-Source-Bedrohungen: Regelmäßige Aktualisierungen, die es Unternehmen ermöglichen, stets über die neuesten Bedrohungen informiert zu sein. Umfassende Bedrohungsanalyse: Detaillierte Informationen zu Bedrohungen, die aus Open-Source-Quellen stammen und für die Cybersicherheit von Bedeutung sind. Integration in bestehende Sicherheitslösungen: Kaspersky Threat Data Feeds lassen sich problemlos in vorhandene Sicherheitssysteme integrieren, um einen ganzheitlichen Schutz zu gewährleisten. Unterstützung für maschinenlesbare Formate: Die Bedrohungsdaten werden in Formaten wie STIX und TAXII bereitgestellt, was die automatische Verarbeitung und Integration erleichtert. Proaktive Bedrohungserkennung: Unternehmen können dank der umfassenden Bedrohungsinformationen proaktive Sicherheitsstrategien entwickeln und umsetzen. Vorteile für Ihr Unternehmen Frühzeitige Bedrohungserkennung: Die Echtzeit-Updates und umfassenden Informationen ermöglichen eine schnelle Identifizierung und Abwehr potenzieller Bedrohungen. Gezielte Abwehrmaßnahmen: Durch die detaillierte Bedrohungsanalyse können Unternehmen ihre Sicherheitsmaßnahmen gezielt anpassen und verbessern. Erhöhte Cybersicherheitsresilienz: Die proaktive Überwachung und Analyse von Open-Source-Bedrohungen erhöhen die Widerstandsfähigkeit gegenüber Cyberangriffen. Effiziente Ressourcenallokation: Die präzisen Bedrohungsdaten helfen Unternehmen, ihre Sicherheitsressourcen optimal einzusetzen und gezielte Maßnahmen zu ergreifen. Compliance und Risikomanagement: Die Lösung unterstützt Unternehmen bei der Einhaltung gesetzlicher Anforderungen und bei der effektiven Verwaltung von Cyberrisiken. Integration und Nutzung **Kaspersky Threat Data Feeds - Open Source Threats** kann problemlos in bestehende Sicherheitssysteme und -infrastrukturen integriert werden. Die Bedrohungsdaten werden in maschinenlesbaren Formaten wie STIX und TAXII bereitgestellt, sodass Unternehmen sie automatisch in ihre Systeme importieren und verarbeiten können. Diese Bedrohungsfeeds sind besonders hilfreich für Unternehmen, die ihre Cybersicherheitsstrategien kontinuierlich verbessern und ihre IT-Infrastruktur proaktiv schützen möchten. Anwendungsfälle für Kaspersky Threat Data Feeds - Open Source Threats Überwachung der Open-Source-Bedrohungslandschaft: Diese Lösung ist ideal für Unternehmen, die kontinuierlich über Bedrohungen aus Open-Source-Quellen informiert bleiben möchten. Frühzeitige Identifikation von Bedrohungen: Die Bedrohungsfeeds unterstützen die schnelle Erkennung und Abwehr potenzieller Cyberbedrohungen. Unterstützung bei der Entwicklung von Sicherheitsrichtlinien: Die bereitgestellten Informationen helfen bei der Erstellung gezielter Sicherheitsrichtlinien und der Stärkung der Cybersicherheitsmaßnahmen.31987,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Complete Guide to Open Source Big Data Stack, Fachbücher von Michael FramptonSehen Sie, wie ein auf Mesos basierender Big-Data-Stack erstellt wird und welche Komponenten verwendet werden. Sie werden derzeit verfügbare Apache-Systeme, sowohl vollständige als auch in der Inkubation befindliche, nutzen. Die Komponenten werden anhand von Beispielen vorgestellt, und Sie lernen, wie sie zusammenarbeiten. Im vollständigen Leitfaden zum Open-Source-Big-Data-Stack beginnt der Autor mit der Erstellung einer privaten Cloud und installiert und untersucht dann Apache Brooklyn. Anschliessend verwendet er jedes Kapitel, um ein Stück des Big-Data-Stacks vorzustellen, und teilt mit, wie man die Software beschafft und installiert. Sie lernen Schritt für Schritt und Kapitel für Kapitel anhand einfacher Beispiele, während ein echter Big-Data-Stack erstellt wird. Das Buch konzentriert sich auf Apache-basierte Systeme und bietet detaillierte Beispiele für Cloud-Speicher, Release-Management, Ressourcenmanagement, Verarbeitung, Warteschlangen, Frameworks, Datenvisualisierung und mehr. Was Sie lernen werden: - Installieren Sie eine private Cloud auf dem lokalen Cluster mit Apache Cloud Stack - Beschaffen, installieren und konfigurieren Sie Apache: Brooklyn, Mesos, Kafka und Zeppelin - Sehen Sie, wie Brooklyn verwendet werden kann, um Mule ESB in einem Cluster und Cassandra in der Cloud zu installieren - Installieren und verwenden Sie DCOS für die Big-Data-Verarbeitung - Verwenden Sie Apache Spark für die Datenverarbeitung im Big-Data-Stack Für wen dieses Buch gedacht ist: Entwickler, Architekten, IT-Projektmanager, Datenbankadministratoren und andere, die mit der Entwicklung oder Unterstützung eines Big-Data-Systems beauftragt sind. Es richtet sich auch an alle, die an Hadoop oder Big Data interessiert sind, sowie an diejenigen, die Probleme mit der Datengrösse haben.55,73 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
The Data Warehouse Lifecycle Toolkit, Fachbücher von Ralph Kimball, Warren Thornthwaite, Joy Mundy, Margy Ross, Bob BeckerDas Buch "The Data Warehouse Lifecycle Toolkit" von John Wiley & Sons bietet eine umfassende Aktualisierung des Branchenstandards für das Design, die Entwicklung und den Einsatz von Data-Warehouse- und Business-Intelligence-Systemen. Seit der ersten Veröffentlichung im Jahr 1998 hat sich die Welt des Data Warehousing erheblich verändert, und dieses Werk reflektiert diese Entwicklungen. Mit einem kartonierten Einband und 672 Seiten ist es ein umfangreiches Nachschlagewerk, das Fachleuten und Studierenden gleichermassen wertvolle Einblicke und praxisnahe Anleitungen bietet. Die Inhalte sind in englischer Sprache verfasst und decken alle Aspekte des Lebenszyklus eines Data Warehouses ab, von der Planung über die Implementierung bis hin zur Wartung. Dieses Buch ist ein unverzichtbares Hilfsmittel für alle, die sich mit der Gestaltung und Optimierung von Datenarchitekturen beschäftigen und die neuesten Trends und Technologien in diesem sich schnell entwickelnden Bereich verstehen möchten.59,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Was ist der Unterschied zwischen ERP und Data Warehouse?
Ein ERP-System (Enterprise Resource Planning) ist eine Softwarelösung, die verschiedene Geschäftsprozesse in einem Unternehmen integriert und automatisiert. Es ermöglicht die Verwaltung von Ressourcen wie Finanzen, Personal, Produktion und Vertrieb. Ein Data Warehouse hingegen ist eine Datenbank, die speziell für die Analyse und Berichterstattung von großen Mengen an Unternehmensdaten entwickelt wurde. Es dient dazu, Daten aus verschiedenen Quellen zu sammeln, zu organisieren und zu analysieren, um fundierte Entscheidungen zu treffen. Während ein ERP-System die operative Geschäftstätigkeit unterstützt, konzentriert sich ein Data Warehouse auf die Analyse und Berichterstattung von Daten. **
-
Was ist der Unterschied zwischen einer Datenbank und einem Data Warehouse?
Eine Datenbank ist eine strukturierte Sammlung von Daten, die für den täglichen Betrieb eines Unternehmens verwendet wird. Sie dient der Speicherung, Verwaltung und Abfrage von Daten. Ein Data Warehouse ist hingegen eine spezielle Art von Datenbank, die große Mengen an Daten aus verschiedenen Quellen sammelt, integriert und für Analysen und Berichterstattung optimiert. Es dient dazu, Daten aus verschiedenen Quellen zu konsolidieren und eine einheitliche Sicht auf die Daten zu ermöglichen. **
-
Was ist der Unterschied zwischen Masterdaten und Transaktionsdaten in SAP und im Data Warehouse?
Masterdaten sind grundlegende Informationen über Geschäftspartner, Produkte, Standorte usw., die in SAP und im Data Warehouse als Referenzdaten verwendet werden. Transaktionsdaten sind dagegen spezifische Informationen über Geschäftsvorgänge wie Verkäufe, Einkäufe, Buchungen usw., die in SAP und im Data Warehouse gespeichert werden, um Analysen und Berichte zu erstellen. Der Hauptunterschied besteht darin, dass Masterdaten statisch und langfristig sind, während Transaktionsdaten dynamisch und kurzfristig sind. **
-
Wie können Daten aus verschiedenen Quellen extrahiert und effizient in einem Data-Warehouse oder einer Datenbank zusammengeführt werden?
Durch die Verwendung von ETL-Prozessen (Extrahieren, Transformieren, Laden) können Daten aus verschiedenen Quellen extrahiert, bereinigt und in einem einheitlichen Format gespeichert werden. Dabei werden Tools wie ETL-Tools oder Data Integration Platforms eingesetzt, um den Prozess effizient zu gestalten. Die Daten können dann in einem Data-Warehouse oder einer Datenbank zusammengeführt und für Analysen und Reporting genutzt werden. **
Wie kann ich das Windows-Setup-EMS-Enabled löschen?
Um das Windows-Setup-EMS-Enabled zu löschen, müssen Sie in die Systemkonfiguration gehen. Öffnen Sie dazu das Startmenü und geben Sie "msconfig" ein. Klicken Sie dann auf die Registerkarte "Start" und deaktivieren Sie das Kontrollkästchen neben "Windows-Setup-EMS-Enabled". Speichern Sie die Änderungen und starten Sie den Computer neu, um die Einstellung zu entfernen. **
Wie kann der "Kernel Data Inpage Error" behoben werden?
Der "Kernel Data Inpage Error" tritt normalerweise aufgrund von Problemen mit der Festplatte oder dem Arbeitsspeicher auf. Um das Problem zu beheben, können Sie zunächst einen Virenscan durchführen, um sicherzustellen, dass Ihr System nicht von Malware infiziert ist. Überprüfen Sie dann die Festplatte auf Fehler und führen Sie gegebenenfalls eine Reparatur durch. Wenn das Problem weiterhin besteht, sollten Sie den Arbeitsspeicher überprüfen und gegebenenfalls austauschen. **
Top-Angebote
Produkte zum Begriff Groupware-enabled-Data-Warehouse:
-
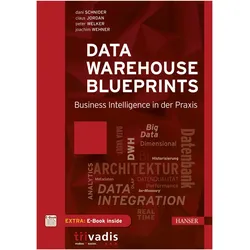
Data Warehouse Blueprints, Fachbücher von Dani SchniderData-Warehouse-Lösungen mit Blueprints erfolgreich umsetzen. Dieses Buch gibt Ihnen einen Überblick über eine typische Data-Warehouse-Architektur und zeigt anhand von zahlreichen Best Practice-Beispielen, wie Sie die einzelnen Komponenten eines Data Warehouses realisieren und betreiben können. Skalierbarkeit, Performance und Integration sind dabei die wichtigsten Erfolgsfaktoren. Der kompakte und kompetente Leitfaden für Ihr Projekt. Warum benötigt man eine Staging Area? Wie sollen fehlende oder fehlerhafte Daten beim Ladeprozess behandelt werden? Ist es zweckmässiger, einen oder mehrere Data Marts zu erstellen? Wo werden die Daten aus verschiedenen Datenquellen integriert und wie sollen sie historisiert werden? Zu diesen und vielen weiteren Fragen erhalten Sie Antworten sowie Tipps und Tricks aus der Praxis. Wertvolles Know-how aus der Praxis. Profitieren Sie von der langjährigen Erfahrung.42,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Snowflake Data Warehouse Engineering, Fachbücher von Martin HanderDas Fachbuch "Snowflake Data Warehouse Engineering" bietet eine umfassende Einführung in die Architektur, Modellierung, ELT-Pipelines und den Betrieb von Snowflake-Datenlagern. Es richtet sich an Fachleute und Praktiker, die ihre Kenntnisse in der Datenkommunikation und Netzwerktechnologie vertiefen möchten. Die erste Auflage des Buches behandelt sowohl grundlegende als auch fortgeschrittene Konzepte und bietet praxisnahe Beispiele, die es den Lesern ermöglichen, die theoretischen Grundlagen in realen Anwendungen umzusetzen. Die klare Struktur und die verständliche Sprache machen es zu einem wertvollen Nachschlagewerk für alle, die im Bereich Datenmanagement tätig sind. Dieses Buch ist ein unverzichtbares Werkzeug für alle, die die Möglichkeiten von Snowflake optimal nutzen möchten.45,40 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Building a Scalable Data Warehouse with Data Vault 2.0, Fachbücher von Michael Olschimke, Dan LinstedtDas Data Vault wurde von Dan Linstedt im US-Verteidigungsministerium erfunden und der Standard wurde erfolgreich auf Data-Warehousing-Projekte in Organisationen unterschiedlicher Grössenordnungen angewendet, von kleinen bis hin zu grossen Unternehmen. Aufgrund seines vereinfachten Designs, das von der Natur inspiriert ist, hilft der Data Vault 2.0-Standard, typische Misserfolge im Data Warehousing zu vermeiden. "Building a Scalable Data Warehouse" behandelt alles, was man wissen muss, um ein skalierbares Data Warehouse von Anfang bis Ende zu erstellen, einschliesslich einer Präsentation der Data Vault-Modellierungstechnik, die die Grundlagen für die Erstellung einer technischen Data Warehouse-Schicht bietet. Das Buch erörtert, wie man das Data Warehouse schrittweise unter Verwendung der agilen Data Vault 2.0-Methodik aufbaut. Darüber hinaus lernen die Leser, wie sie die Eingabeschicht (die Staging-Schicht) und die Präsentationsschicht (Data Mart) der Data Vault 2.0-Architektur erstellen können.63,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Open Source ThreatsKaspersky Threat Data Feeds – Open Source Threats In einer Zeit, in der Cyberbedrohungen komplexer und zielgerichteter denn je sind, ist eine umfassende Bedrohungsüberwachung unerlässlich. **Kaspersky Threat Data Feeds - Open Source Threats** stellt eine innovative Lösung dar, die Sicherheitsverantwortlichen aktuelle und relevante Informationen zu Bedrohungen bietet, die aus Open-Source-Quellen stammen. Diese Bedrohungsfeeds ermöglichen es Unternehmen, sich kontinuierlich über die neuesten Bedrohungen aus dem Open-Source-Bereich zu informieren und ihre Sicherheitsmaßnahmen entsprechend anzupassen. Mit Kaspersky Threat Data Feeds - Open Source Threats können Unternehmen proaktiv auf Bedrohungen reagieren und so ihre Widerstandsfähigkeit gegenüber Cyberangriffen deutlich verbessern. Überblick über Kaspersky Threat Data Feeds - Open Source Threats Die Lösung **Kaspersky Threat Data Feeds - Open Source Threats** bietet Unternehmen Zugang zu einer Fülle an Bedrohungsdaten, die speziell aus Open-Source-Quellen gesammelt werden. Diese Feeds bieten detaillierte Informationen über aktuelle Bedrohungen und ermöglichen eine proaktive Abwehr. Durch die kontinuierliche Analyse und Filterung relevanter Daten aus öffentlich zugänglichen Quellen hilft Kaspersky Unternehmen dabei, potenzielle Gefahren frühzeitig zu erkennen und geeignete Schutzmaßnahmen zu implementieren. Hauptfunktionen Echtzeit-Updates zu Open-Source-Bedrohungen: Regelmäßige Aktualisierungen, die es Unternehmen ermöglichen, stets über die neuesten Bedrohungen informiert zu sein. Umfassende Bedrohungsanalyse: Detaillierte Informationen zu Bedrohungen, die aus Open-Source-Quellen stammen und für die Cybersicherheit von Bedeutung sind. Integration in bestehende Sicherheitslösungen: Kaspersky Threat Data Feeds lassen sich problemlos in vorhandene Sicherheitssysteme integrieren, um einen ganzheitlichen Schutz zu gewährleisten. Unterstützung für maschinenlesbare Formate: Die Bedrohungsdaten werden in Formaten wie STIX und TAXII bereitgestellt, was die automatische Verarbeitung und Integration erleichtert. Proaktive Bedrohungserkennung: Unternehmen können dank der umfassenden Bedrohungsinformationen proaktive Sicherheitsstrategien entwickeln und umsetzen. Vorteile für Ihr Unternehmen Frühzeitige Bedrohungserkennung: Die Echtzeit-Updates und umfassenden Informationen ermöglichen eine schnelle Identifizierung und Abwehr potenzieller Bedrohungen. Gezielte Abwehrmaßnahmen: Durch die detaillierte Bedrohungsanalyse können Unternehmen ihre Sicherheitsmaßnahmen gezielt anpassen und verbessern. Erhöhte Cybersicherheitsresilienz: Die proaktive Überwachung und Analyse von Open-Source-Bedrohungen erhöhen die Widerstandsfähigkeit gegenüber Cyberangriffen. Effiziente Ressourcenallokation: Die präzisen Bedrohungsdaten helfen Unternehmen, ihre Sicherheitsressourcen optimal einzusetzen und gezielte Maßnahmen zu ergreifen. Compliance und Risikomanagement: Die Lösung unterstützt Unternehmen bei der Einhaltung gesetzlicher Anforderungen und bei der effektiven Verwaltung von Cyberrisiken. Integration und Nutzung **Kaspersky Threat Data Feeds - Open Source Threats** kann problemlos in bestehende Sicherheitssysteme und -infrastrukturen integriert werden. Die Bedrohungsdaten werden in maschinenlesbaren Formaten wie STIX und TAXII bereitgestellt, sodass Unternehmen sie automatisch in ihre Systeme importieren und verarbeiten können. Diese Bedrohungsfeeds sind besonders hilfreich für Unternehmen, die ihre Cybersicherheitsstrategien kontinuierlich verbessern und ihre IT-Infrastruktur proaktiv schützen möchten. Anwendungsfälle für Kaspersky Threat Data Feeds - Open Source Threats Überwachung der Open-Source-Bedrohungslandschaft: Diese Lösung ist ideal für Unternehmen, die kontinuierlich über Bedrohungen aus Open-Source-Quellen informiert bleiben möchten. Frühzeitige Identifikation von Bedrohungen: Die Bedrohungsfeeds unterstützen die schnelle Erkennung und Abwehr potenzieller Cyberbedrohungen. Unterstützung bei der Entwicklung von Sicherheitsrichtlinien: Die bereitgestellten Informationen helfen bei der Erstellung gezielter Sicherheitsrichtlinien und der Stärkung der Cybersicherheitsmaßnahmen.31987,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert ein Data Warehouse?
Ein Data Warehouse ist eine spezialisierte Datenbank, die große Mengen an strukturierten und unstrukturierten Daten aus verschiedenen Quellen sammelt, speichert und verwaltet. Es dient dazu, Daten zu konsolidieren, zu analysieren und für Entscheidungsfindungen zugänglich zu machen. Um ein Data Warehouse zu erstellen, werden Daten aus verschiedenen operativen Systemen extrahiert, transformiert und geladen (ETL-Prozess). Die Daten werden dann in einem zentralen Repository gespeichert, wo sie für Analysen und Berichterstellung zur Verfügung stehen. Data Warehouses verwenden spezielle Datenmodellierungstechniken wie den Stern- oder Schneeflockenschema, um Daten effizient zu strukturieren und abzufragen. Business Intelligence Tools werden häufig verwendet, um Daten aus dem Data Warehouse zu extrahieren, zu analysieren und in aussagekräftige Berichte und Dashboards umzuwandeln. Durch die zentrale Speicherung und Aufbereitung von Daten ermöglicht ein Data Warehouse Unternehmen, fundierte Entscheidungen zu treffen, Trends zu identifizieren und Geschäftsprozesse zu optimieren. **
-
Was ist ein Data Warehouse?
Was ist ein Data Warehouse? **
-
Was ist der Unterschied zwischen ERP und Data Warehouse?
Ein ERP-System (Enterprise Resource Planning) ist eine Softwarelösung, die verschiedene Geschäftsprozesse in einem Unternehmen integriert und automatisiert. Es ermöglicht die Verwaltung von Ressourcen wie Finanzen, Personal, Produktion und Vertrieb. Ein Data Warehouse hingegen ist eine Datenbank, die speziell für die Analyse und Berichterstattung von großen Mengen an Unternehmensdaten entwickelt wurde. Es dient dazu, Daten aus verschiedenen Quellen zu sammeln, zu organisieren und zu analysieren, um fundierte Entscheidungen zu treffen. Während ein ERP-System die operative Geschäftstätigkeit unterstützt, konzentriert sich ein Data Warehouse auf die Analyse und Berichterstattung von Daten. **
-
Was ist der Unterschied zwischen einer Datenbank und einem Data Warehouse?
Eine Datenbank ist eine strukturierte Sammlung von Daten, die für den täglichen Betrieb eines Unternehmens verwendet wird. Sie dient der Speicherung, Verwaltung und Abfrage von Daten. Ein Data Warehouse ist hingegen eine spezielle Art von Datenbank, die große Mengen an Daten aus verschiedenen Quellen sammelt, integriert und für Analysen und Berichterstattung optimiert. Es dient dazu, Daten aus verschiedenen Quellen zu konsolidieren und eine einheitliche Sicht auf die Daten zu ermöglichen. **
Ähnliche Suchbegriffe für Groupware-enabled-Data-Warehouse
-
Complete Guide to Open Source Big Data Stack, Fachbücher von Michael FramptonSehen Sie, wie ein auf Mesos basierender Big-Data-Stack erstellt wird und welche Komponenten verwendet werden. Sie werden derzeit verfügbare Apache-Systeme, sowohl vollständige als auch in der Inkubation befindliche, nutzen. Die Komponenten werden anhand von Beispielen vorgestellt, und Sie lernen, wie sie zusammenarbeiten. Im vollständigen Leitfaden zum Open-Source-Big-Data-Stack beginnt der Autor mit der Erstellung einer privaten Cloud und installiert und untersucht dann Apache Brooklyn. Anschliessend verwendet er jedes Kapitel, um ein Stück des Big-Data-Stacks vorzustellen, und teilt mit, wie man die Software beschafft und installiert. Sie lernen Schritt für Schritt und Kapitel für Kapitel anhand einfacher Beispiele, während ein echter Big-Data-Stack erstellt wird. Das Buch konzentriert sich auf Apache-basierte Systeme und bietet detaillierte Beispiele für Cloud-Speicher, Release-Management, Ressourcenmanagement, Verarbeitung, Warteschlangen, Frameworks, Datenvisualisierung und mehr. Was Sie lernen werden: - Installieren Sie eine private Cloud auf dem lokalen Cluster mit Apache Cloud Stack - Beschaffen, installieren und konfigurieren Sie Apache: Brooklyn, Mesos, Kafka und Zeppelin - Sehen Sie, wie Brooklyn verwendet werden kann, um Mule ESB in einem Cluster und Cassandra in der Cloud zu installieren - Installieren und verwenden Sie DCOS für die Big-Data-Verarbeitung - Verwenden Sie Apache Spark für die Datenverarbeitung im Big-Data-Stack Für wen dieses Buch gedacht ist: Entwickler, Architekten, IT-Projektmanager, Datenbankadministratoren und andere, die mit der Entwicklung oder Unterstützung eines Big-Data-Systems beauftragt sind. Es richtet sich auch an alle, die an Hadoop oder Big Data interessiert sind, sowie an diejenigen, die Probleme mit der Datengrösse haben.55,73 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
The Data Warehouse Lifecycle Toolkit, Fachbücher von Ralph Kimball, Warren Thornthwaite, Joy Mundy, Margy Ross, Bob BeckerDas Buch "The Data Warehouse Lifecycle Toolkit" von John Wiley & Sons bietet eine umfassende Aktualisierung des Branchenstandards für das Design, die Entwicklung und den Einsatz von Data-Warehouse- und Business-Intelligence-Systemen. Seit der ersten Veröffentlichung im Jahr 1998 hat sich die Welt des Data Warehousing erheblich verändert, und dieses Werk reflektiert diese Entwicklungen. Mit einem kartonierten Einband und 672 Seiten ist es ein umfangreiches Nachschlagewerk, das Fachleuten und Studierenden gleichermassen wertvolle Einblicke und praxisnahe Anleitungen bietet. Die Inhalte sind in englischer Sprache verfasst und decken alle Aspekte des Lebenszyklus eines Data Warehouses ab, von der Planung über die Implementierung bis hin zur Wartung. Dieses Buch ist ein unverzichtbares Hilfsmittel für alle, die sich mit der Gestaltung und Optimierung von Datenarchitekturen beschäftigen und die neuesten Trends und Technologien in diesem sich schnell entwickelnden Bereich verstehen möchten.59,80 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
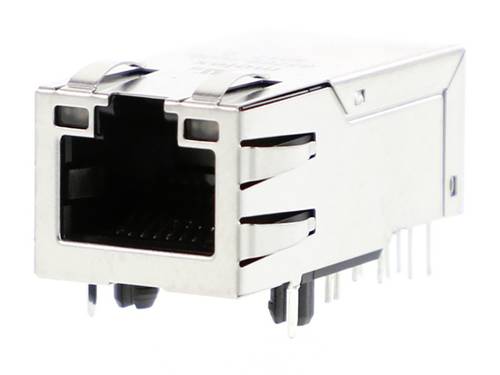
Molex 857891006 PoE Enabled 1x1 857891006 SteckerMXMag Gigabit Ethernet 8 Core PoE+ 30W Single-Port RJ45 Connector, 33.02mm Depth, 3.15mm Phy Pin Length, Right-Angle, Inverted Profile, with Shield Tabs, with Green/Yellow LEDs, Standard Temperature, Tray380,75 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Data WarehouseData Warehouse , Einführung für die Praxis , Rück- & Bremsleuchten > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20240718, Produktform: Kartoniert, Redaktion: Caldarola, Maria Cristina, Auflage: 24001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 363, Abbildungen: mit 19 Abbildungen und 11 Tabellen, Keyword: Blockchain; Datenschutz; Eigentum an Daten; Open Data; Peer-to-Peer Netzwerke; Risikoanalyse; Verschlüsselung, Fachschema: Datenschutzrecht~Verfassungsrecht~Öffentliches Recht, Fachkategorie: Öffentliches Recht, Warengruppe: HC/Öffentliches Recht, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Blätteranzahl: 363 Blätter, Länge: 240, Breite: 160, Höhe: 21, Gewicht: 594, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft,89,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen Masterdaten und Transaktionsdaten in SAP und im Data Warehouse?
Masterdaten sind grundlegende Informationen über Geschäftspartner, Produkte, Standorte usw., die in SAP und im Data Warehouse als Referenzdaten verwendet werden. Transaktionsdaten sind dagegen spezifische Informationen über Geschäftsvorgänge wie Verkäufe, Einkäufe, Buchungen usw., die in SAP und im Data Warehouse gespeichert werden, um Analysen und Berichte zu erstellen. Der Hauptunterschied besteht darin, dass Masterdaten statisch und langfristig sind, während Transaktionsdaten dynamisch und kurzfristig sind. **
-
Wie können Daten aus verschiedenen Quellen extrahiert und effizient in einem Data-Warehouse oder einer Datenbank zusammengeführt werden?
Durch die Verwendung von ETL-Prozessen (Extrahieren, Transformieren, Laden) können Daten aus verschiedenen Quellen extrahiert, bereinigt und in einem einheitlichen Format gespeichert werden. Dabei werden Tools wie ETL-Tools oder Data Integration Platforms eingesetzt, um den Prozess effizient zu gestalten. Die Daten können dann in einem Data-Warehouse oder einer Datenbank zusammengeführt und für Analysen und Reporting genutzt werden. **
-
Wie kann ich das Windows-Setup-EMS-Enabled löschen?
Um das Windows-Setup-EMS-Enabled zu löschen, müssen Sie in die Systemkonfiguration gehen. Öffnen Sie dazu das Startmenü und geben Sie "msconfig" ein. Klicken Sie dann auf die Registerkarte "Start" und deaktivieren Sie das Kontrollkästchen neben "Windows-Setup-EMS-Enabled". Speichern Sie die Änderungen und starten Sie den Computer neu, um die Einstellung zu entfernen. **
-
Wie kann der "Kernel Data Inpage Error" behoben werden?
Der "Kernel Data Inpage Error" tritt normalerweise aufgrund von Problemen mit der Festplatte oder dem Arbeitsspeicher auf. Um das Problem zu beheben, können Sie zunächst einen Virenscan durchführen, um sicherzustellen, dass Ihr System nicht von Malware infiziert ist. Überprüfen Sie dann die Festplatte auf Fehler und führen Sie gegebenenfalls eine Reparatur durch. Wenn das Problem weiterhin besteht, sollten Sie den Arbeitsspeicher überprüfen und gegebenenfalls austauschen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.