Domain linux-news.de kaufen?
Wir ziehen mit dem Projekt
linux-news.de um.
Sind Sie am Kauf der Domain
linux-news.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain linux-news.de kaufen?
Wie können wir die Duplikation von Daten effizient vermeiden?
Durch die Implementierung von Datenvalidierungsregeln und -prozessen, um sicherzustellen, dass nur korrekte und eindeutige Daten eingeführt werden. Verwendung von eindeutigen Identifikatoren und Schlüsseln, um Duplikate zu identifizieren und zu vermeiden. Regelmäßige Überprüfung und Bereinigung der Datenbank, um vorhandene Duplikate zu entfernen und die Datenqualität zu verbessern. **
Wie kann die Duplikation von Daten effektiv vermieden oder kontrolliert werden?
Die Verwendung von eindeutigen Identifikatoren für jede Dateneinheit kann Duplikate verhindern. Regelmäßige Überprüfungen der Datenbank auf Duplikate können helfen, bereits vorhandene Duplikate zu identifizieren und zu entfernen. Die Implementierung von automatisierten Prozessen zur Validierung und Bereinigung von Daten kann auch dazu beitragen, die Duplikation zu kontrollieren. **

Ähnliche Suchbegriffe für Daten-Duplikation
Top-Angebote
Produkte zum Begriff Daten-Duplikation:
-
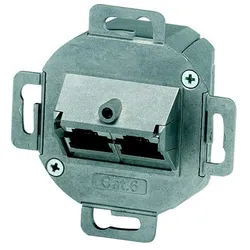
Mennekes Daten-Anschlussdose 41452Aufputzmontage=neinUnterputzmontage=neinKanaleinbau=neinBodentank/Unterflurmontage=neinBefestigungsart=schraubenZusammenstellung=Basiselement mit KomplettgehäuseSteckverbindertyp=2x RJ45 8(4)Mit Buchsen/Kupplungen=jaGeeignet für Anzahl Buchsen/Kupplungen=2Kategorie=6Farbe=sonstigeAnschlussart=LSABuchsen geschirmt=neinGehäuse geschirmt=neinSeparater Erdungsanschluss=neinMit Textfeld=jaDesignfähig=jaSeparate Kabelzugentlastung=jaMontageart Schirmanschluss=ohneAuslassrichtung=untenMit Staubschutz=neinMit Abschlusswiderstand=neinSchutzart (IP)=IP44Mechanische Codierung=neinFarbcodierung=neinGerätebreite=70 mmGerätehöhe=40 mmGerätetiefe=70 mm53,82 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Understanding the Linux Kernel 3e, Fachbücher von Marco CesatiUm zu verstehen, was Linux ausmacht und warum es auf einer Vielzahl von Systemen so gut funktioniert, müssen Sie tief in das Herz des Kernels eintauchen. Der Kernel steuert alle Interaktionen zwischen der CPU und der Aussenwelt und bestimmt, welche Programme Prozessorzeit teilen und in welcher Reihenfolge. Er verwaltet den begrenzten Speicher so gut, dass Hunderte von Prozessen das System effizient nutzen können, und organisiert Datenübertragungen so geschickt, dass die CPU nicht länger als nötig auf die relativ langsamen Festplatten warten muss. Die dritte Auflage von "Understanding the Linux Kernel" nimmt Sie mit auf eine geführte Tour durch die bedeutendsten Datenstrukturen, Algorithmen und Programmiertricks, die im Kernel verwendet werden. Über oberflächliche Merkmale hinaus bieten die Autoren wertvolle Einblicke für Menschen, die wissen möchten, wie die Dinge in ihrer Maschine wirklich funktionieren. Wichtige, Intel-spezifische Funktionen werden besprochen. Relevante Codeabschnitte werden Zeile für Zeile zerlegt. Doch das Buch behandelt mehr als nur die Funktionsweise des Codes; es erklärt die theoretischen Grundlagen, warum Linux die Dinge auf die Art und Weise tut, wie es sie tut. Diese Ausgabe des Buches behandelt Version 2.6, die bedeutende Änderungen an nahezu jedem Kernel-Subsystem mit sich brachte, insbesondere in den Bereichen Speichermanagement und Blockgeräte. Das Buch konzentriert sich auf folgende Themen: - Speichermanagement, einschliesslich Dateipufferung, Prozessauslagerung und Direct Memory Access (DMA) - Die virtuelle Dateisystemschicht und die zweiten und dritten erweiterten Dateisysteme - Prozesscreation und -planung - Signale, Interrupts und die wesentlichen Schnittstellen zu Gerätetreibern - Timing - Synchronisation innerhalb des Kernels - Interprozesskommunikation (IPC) - Programmausführung "Understanding the Linux Kernel" wird Sie mit allen inneren Abläufen von Linux vertraut machen, aber es ist mehr als nur eine akademische Übung. Sie werden lernen, unter welchen Bedingungen Linux die beste Leistung erbringt, und Sie werden sehen, wie es die Herausforderung meistert, eine gute Systemreaktion zu bieten.56,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie kann die Duplikation von Daten und Informationen effektiv vermieden werden?
Die Verwendung von eindeutigen Identifikatoren für jede Dateneinheit kann Duplikationen verhindern. Regelmäßige Datenbereinigung und -validierung helfen, redundante Informationen zu identifizieren und zu entfernen. Die Implementierung von Datenbankregeln und -richtlinien kann auch dazu beitragen, die Duplikation von Daten zu minimieren. **
-
Wie kann die Duplikation von Daten effizient und zuverlässig vermieden werden?
Durch die Implementierung von deduplizierenden Speicherlösungen, die identische Datenblöcke erkennen und nur einmal speichern. Regelmäßige Überprüfung und Bereinigung von Datenbeständen, um redundante Informationen zu identifizieren und zu entfernen. Schulung der Mitarbeiter im Umgang mit Daten, um die Entstehung von Duplikaten zu minimieren. **
-
Wie kann die Duplikation von Daten effizient und fehlerfrei durchgeführt werden?
Die Verwendung von spezieller Software oder Tools kann helfen, Daten effizient zu duplizieren. Vor der Duplikation sollten Daten auf Fehler überprüft und bereinigt werden. Regelmäßige Backups und die Verwendung von deduplizierter Speicherung können helfen, Fehler bei der Daten-Duplikation zu minimieren. **
-
Wie kann die Duplikation von Daten effizient und kostengünstig gehandhabt werden?
Die Duplikation von Daten kann effizient durch den Einsatz von Deduplizierungstechnologien reduziert werden, die identische Datenblöcke erkennen und nur einmal speichern. Zudem können Datenkompressionsalgorithmen eingesetzt werden, um den Speicherplatzbedarf zu minimieren. Eine regelmäßige Überprüfung und Bereinigung von veralteten oder unnötigen Daten kann ebenfalls dazu beitragen, die Kosten für die Datenspeicherung zu senken. **


Wie kann die Duplikation von Daten effizient verhindert werden? Wie wirkt sich die Duplikation von Inhalten auf die Effizienz eines Unternehmens aus?
Die Duplikation von Daten kann effizient verhindert werden, indem ein zentrales Datenmanagement-System eingesetzt wird, das die Speicherung und Aktualisierung von Informationen koordiniert. Durch die Verwendung von deduplizierender Software können redundante Daten automatisch erkannt und entfernt werden. Die Duplikation von Inhalten kann die Effizienz eines Unternehmens beeinträchtigen, da sie zu Verwirrung, Inkonsistenzen und erhöhtem Speicherbedarf führen kann. **
Wie kann die Duplikation von Inhalten vermieden werden, um Urheberrechtsverletzungen zu verhindern? Was sind die Auswirkungen der Duplikation von Daten auf die Effizienz und Sicherheit von Informationssystemen?
Die Duplikation von Inhalten kann vermieden werden, indem man sicherstellt, dass alle Inhalte eindeutig gekennzeichnet und zentral gespeichert sind. Regelmäßige Überprüfungen und Schulungen der Mitarbeiter können ebenfalls dazu beitragen, Urheberrechtsverletzungen zu verhindern. Die Duplikation von Daten kann die Effizienz von Informationssystemen beeinträchtigen, da redundante Informationen die Suche und Verarbeitung von Daten verlangsamen können. Zudem erhöht die Duplikation das Risiko von Inkonsistenzen und Fehlern in den Daten, was die Sicherheit des Informationssystems gefährden kann. Es ist daher wichtig, Duplikate zu identifizieren und zu entfernen, um die Effizienz und Sicherheit des Systems **
Top-Angebote
Produkte zum Begriff Daten-Duplikation:
-
Forensisch-psychologische Glaubwürdigkeitsbegutachtung, SORKC-Modell und Evaluation durch L-Daten, T-Daten und Q-Daten, Taschenbuch von Anonymous,Forensisch-psychologische Glaubwürdigkeitsbegutachtung, Sorkc-modell Und Evaluation Durch L-daten, T-daten Und Q-daten, Taschenbuch Von Anonymous, Grin, 978-3-346-51308-3, Seitenanzahl: 249,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Yarbo Ersatz Daten CenterBesonderheiten des Daten CentersLiefert präzise Navigationsdaten an den Yarbo Core Verbindung mit Ihrem Heimnetzwerk über Ethernet (30-m-Kabel im Lieferumfang enthalten) Ausgestattet mit RTK-, Bluetooth- und HaLow-WLAN-AntennenLieferumfang:1x Yarbo Ersatz Daten CenterInformationen und Downloads: Yarbo Schnellstartanleitung (engl.) Yarbo Produktvorstellung (engl.) Yarbo Bedienungsanleitung (engl.)...329,00 €*Versand: 159,00 €Sichere Weiterleitung zum Anbieter
-
Mennekes Daten-Anschlussdose 41452Aufputzmontage=neinUnterputzmontage=neinKanaleinbau=neinBodentank/Unterflurmontage=neinBefestigungsart=schraubenZusammenstellung=Basiselement mit KomplettgehäuseSteckverbindertyp=2x RJ45 8(4)Mit Buchsen/Kupplungen=jaGeeignet für Anzahl Buchsen/Kupplungen=2Kategorie=6Farbe=sonstigeAnschlussart=LSABuchsen geschirmt=neinGehäuse geschirmt=neinSeparater Erdungsanschluss=neinMit Textfeld=jaDesignfähig=jaSeparate Kabelzugentlastung=jaMontageart Schirmanschluss=ohneAuslassrichtung=untenMit Staubschutz=neinMit Abschlusswiderstand=neinSchutzart (IP)=IP44Mechanische Codierung=neinFarbcodierung=neinGerätebreite=70 mmGerätehöhe=40 mmGerätetiefe=70 mm53,82 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Wie können wir die Duplikation von Daten effizient vermeiden?
Durch die Implementierung von Datenvalidierungsregeln und -prozessen, um sicherzustellen, dass nur korrekte und eindeutige Daten eingeführt werden. Verwendung von eindeutigen Identifikatoren und Schlüsseln, um Duplikate zu identifizieren und zu vermeiden. Regelmäßige Überprüfung und Bereinigung der Datenbank, um vorhandene Duplikate zu entfernen und die Datenqualität zu verbessern. **
-
Wie kann die Duplikation von Daten effektiv vermieden oder kontrolliert werden?
Die Verwendung von eindeutigen Identifikatoren für jede Dateneinheit kann Duplikate verhindern. Regelmäßige Überprüfungen der Datenbank auf Duplikate können helfen, bereits vorhandene Duplikate zu identifizieren und zu entfernen. Die Implementierung von automatisierten Prozessen zur Validierung und Bereinigung von Daten kann auch dazu beitragen, die Duplikation zu kontrollieren. **
-
Wie kann die Duplikation von Daten und Informationen effektiv vermieden werden?
Die Verwendung von eindeutigen Identifikatoren für jede Dateneinheit kann Duplikationen verhindern. Regelmäßige Datenbereinigung und -validierung helfen, redundante Informationen zu identifizieren und zu entfernen. Die Implementierung von Datenbankregeln und -richtlinien kann auch dazu beitragen, die Duplikation von Daten zu minimieren. **
-
Wie kann die Duplikation von Daten effizient und zuverlässig vermieden werden?
Durch die Implementierung von deduplizierenden Speicherlösungen, die identische Datenblöcke erkennen und nur einmal speichern. Regelmäßige Überprüfung und Bereinigung von Datenbeständen, um redundante Informationen zu identifizieren und zu entfernen. Schulung der Mitarbeiter im Umgang mit Daten, um die Entstehung von Duplikaten zu minimieren. **
Ähnliche Suchbegriffe für Daten-Duplikation
-
Understanding the Linux Kernel 3e, Fachbücher von Marco CesatiUm zu verstehen, was Linux ausmacht und warum es auf einer Vielzahl von Systemen so gut funktioniert, müssen Sie tief in das Herz des Kernels eintauchen. Der Kernel steuert alle Interaktionen zwischen der CPU und der Aussenwelt und bestimmt, welche Programme Prozessorzeit teilen und in welcher Reihenfolge. Er verwaltet den begrenzten Speicher so gut, dass Hunderte von Prozessen das System effizient nutzen können, und organisiert Datenübertragungen so geschickt, dass die CPU nicht länger als nötig auf die relativ langsamen Festplatten warten muss. Die dritte Auflage von "Understanding the Linux Kernel" nimmt Sie mit auf eine geführte Tour durch die bedeutendsten Datenstrukturen, Algorithmen und Programmiertricks, die im Kernel verwendet werden. Über oberflächliche Merkmale hinaus bieten die Autoren wertvolle Einblicke für Menschen, die wissen möchten, wie die Dinge in ihrer Maschine wirklich funktionieren. Wichtige, Intel-spezifische Funktionen werden besprochen. Relevante Codeabschnitte werden Zeile für Zeile zerlegt. Doch das Buch behandelt mehr als nur die Funktionsweise des Codes; es erklärt die theoretischen Grundlagen, warum Linux die Dinge auf die Art und Weise tut, wie es sie tut. Diese Ausgabe des Buches behandelt Version 2.6, die bedeutende Änderungen an nahezu jedem Kernel-Subsystem mit sich brachte, insbesondere in den Bereichen Speichermanagement und Blockgeräte. Das Buch konzentriert sich auf folgende Themen: - Speichermanagement, einschliesslich Dateipufferung, Prozessauslagerung und Direct Memory Access (DMA) - Die virtuelle Dateisystemschicht und die zweiten und dritten erweiterten Dateisysteme - Prozesscreation und -planung - Signale, Interrupts und die wesentlichen Schnittstellen zu Gerätetreibern - Timing - Synchronisation innerhalb des Kernels - Interprozesskommunikation (IPC) - Programmausführung "Understanding the Linux Kernel" wird Sie mit allen inneren Abläufen von Linux vertraut machen, aber es ist mehr als nur eine akademische Übung. Sie werden lernen, unter welchen Bedingungen Linux die beste Leistung erbringt, und Sie werden sehen, wie es die Herausforderung meistert, eine gute Systemreaktion zu bieten.56,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Fischer, Tin: Linke Daten, Rechte DatenLinke Daten, Rechte Daten , Warum wir nur das sehen, was wir sehen wollen , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20220402, Produktform: Leinen, Autoren: Fischer, Tin, Seitenzahl/Blattzahl: 240, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Statistiken; Gefühlte Wahrheit; Wahrheit; Fake News; Gesundheit; Gesellschaft; Grüne; Umwelt; Klima; Wirtschaft; Geld; Politik; Mario Mensch; Wirtschaftsstatistik; Statistik; Einwanderung, Fachschema: Analyse / Datenanalyse~Datenanalyse~Migration (soziologisch)~Wanderung (soziologisch)~Zuwanderung~Forschung (wirtschafts-, sozialwissenschaftlich) / Sozialforschung~Sozialforschung~Empirische Sozialforschung~Sozialforschung / Empirische Sozialforschung~Umwelt / Politik, Wirtschaft, Planung~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Datenanalyse, allgemein~Sozialforschung und -statistik~Grüne Politik / Ökopolitik / Umweltschutz~Ökonometrie und Wirtschaftsstatistik~Wahrscheinlichkeitsrechnung und Statistik, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Migration, Einwanderung und Auswanderung, Thema: Auseinandersetzen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag, Verlag: Hoffmann und Campe Verlag GmbH, Länge: 215, Breite: 144, Höhe: 26, Gewicht: 402, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 267813525,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Daten-Spürnasen auf SpurensucheDaten-Spürnasen auf Spurensuche , Mit Spannung und Motivation in die Welt der Daten Haben Viertklässler mehr Spiele auf dem Smartphone als Drittklässler? Wie unterscheiden sich Mädchen und Jungen in ihren Hobbys? Brauchen Kinder aus einer Stadt wirklich länger zur Schule als Kinder aus einem Dorf? Daten-Spürnasen finden die Antworten! Bereits Grundschülerinnen und -schüler können in die Rolle von Daten-Spürnasen schlüpfen. Das zeigt dieses Buch. Die Kinder sammeln Daten, betrachten sie unter verschiedenen Perspektiven und finden die Informationen hinter den Daten. Dabei durchlaufen sie den kompletten Zyklus eines statistischen Projekts: von der Fragestellung über die Erhebung bis hin zur Auswertung. Der Einsatz digitaler Werkzeuge unterstützt die Schülerinnen und Schüler, auch umfangreiche Daten unter eigenen Fragestellungen zu untersuchen. An motivierenden und lebensnahen Themen eignen sie sich so nachhaltige Kompetenzen aus dem Inhaltsbereich "Daten, Häufigkeit, Wahrscheinlichkeit" an. "Daten-Spürnasen auf Spurensuche" gibt Orientierung und praxisnahe Anregungen durch: - erprobte Unterrichtssequenzen zur Datenanalyse - mit und ohne digitale Werkzeuge - von Klasse 2 bis 4, - zahlreiche Unterrichtsmaterialien (Arbeitsblätter, Datenkarten, Datensätze) im Buch und als Download, - didaktisch-methodische Informationen zur professionellen Vorbereitung und Durchführung des Unterrichts, - eine Einführung in die Datenanalyse mit der Software TinkerPlots Zielgruppe dieses Buchs sind interessierte Lehrkräfte für Mathematik und Sachunterricht an Grundschulen, Studierende und Referendare sowie Lehrerfortbildner*innen. , Zündspulen > Elektrik & Zündungen , Erscheinungsjahr: 20240821, Produktform: Kartoniert, Redaktion: Biehler, Rolf~Frischemeier, Daniel, Seitenzahl/Blattzahl: 221, Keyword: Daten; Häufigkeit; Wahrscheinlichkeit, Fachschema: Mathematik / Lehrermaterial~Mathematik / Statistik, Bildungsmedien Fächer: Mathematik, Algebra, Geometrie, Bildungszweck: für den Primarbereich~Für die Vorschule (Deutschland), Altersempfehlung / Lesealter: 23, Genaues Alter: GRS, Warengruppe: HC/Schulbücher/Unterrichtsmat./Lehrer, Fachkategorie: Unterricht und Didaktik: Mathematik, Schulform: GRS, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kallmeyer'sche Verlags-, Verlag: Kallmeyer'sche Verlags-, Verlag: Kallmeyer'sche Verlagsbuchhandlung, Länge: 226, Breite: 162, Höhe: 15, Gewicht: 389, Produktform: Klappenbroschur, Genre: Schule und Lernen, Genre: Schule und Lernen, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Schulform: Grundschule, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch,29,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann die Duplikation von Daten effizient und fehlerfrei durchgeführt werden?
Die Verwendung von spezieller Software oder Tools kann helfen, Daten effizient zu duplizieren. Vor der Duplikation sollten Daten auf Fehler überprüft und bereinigt werden. Regelmäßige Backups und die Verwendung von deduplizierter Speicherung können helfen, Fehler bei der Daten-Duplikation zu minimieren. **
-
Wie kann die Duplikation von Daten effizient und kostengünstig gehandhabt werden?
Die Duplikation von Daten kann effizient durch den Einsatz von Deduplizierungstechnologien reduziert werden, die identische Datenblöcke erkennen und nur einmal speichern. Zudem können Datenkompressionsalgorithmen eingesetzt werden, um den Speicherplatzbedarf zu minimieren. Eine regelmäßige Überprüfung und Bereinigung von veralteten oder unnötigen Daten kann ebenfalls dazu beitragen, die Kosten für die Datenspeicherung zu senken. **
-
Wie kann die Duplikation von Daten effizient verhindert werden? Wie wirkt sich die Duplikation von Inhalten auf die Effizienz eines Unternehmens aus?
Die Duplikation von Daten kann effizient verhindert werden, indem ein zentrales Datenmanagement-System eingesetzt wird, das die Speicherung und Aktualisierung von Informationen koordiniert. Durch die Verwendung von deduplizierender Software können redundante Daten automatisch erkannt und entfernt werden. Die Duplikation von Inhalten kann die Effizienz eines Unternehmens beeinträchtigen, da sie zu Verwirrung, Inkonsistenzen und erhöhtem Speicherbedarf führen kann. **
-
Wie kann die Duplikation von Inhalten vermieden werden, um Urheberrechtsverletzungen zu verhindern? Was sind die Auswirkungen der Duplikation von Daten auf die Effizienz und Sicherheit von Informationssystemen?
Die Duplikation von Inhalten kann vermieden werden, indem man sicherstellt, dass alle Inhalte eindeutig gekennzeichnet und zentral gespeichert sind. Regelmäßige Überprüfungen und Schulungen der Mitarbeiter können ebenfalls dazu beitragen, Urheberrechtsverletzungen zu verhindern. Die Duplikation von Daten kann die Effizienz von Informationssystemen beeinträchtigen, da redundante Informationen die Suche und Verarbeitung von Daten verlangsamen können. Zudem erhöht die Duplikation das Risiko von Inkonsistenzen und Fehlern in den Daten, was die Sicherheit des Informationssystems gefährden kann. Es ist daher wichtig, Duplikate zu identifizieren und zu entfernen, um die Effizienz und Sicherheit des Systems **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.